← Tất cả sản phẩm
01 · Desktop · AI audio · 2025
LA Studio
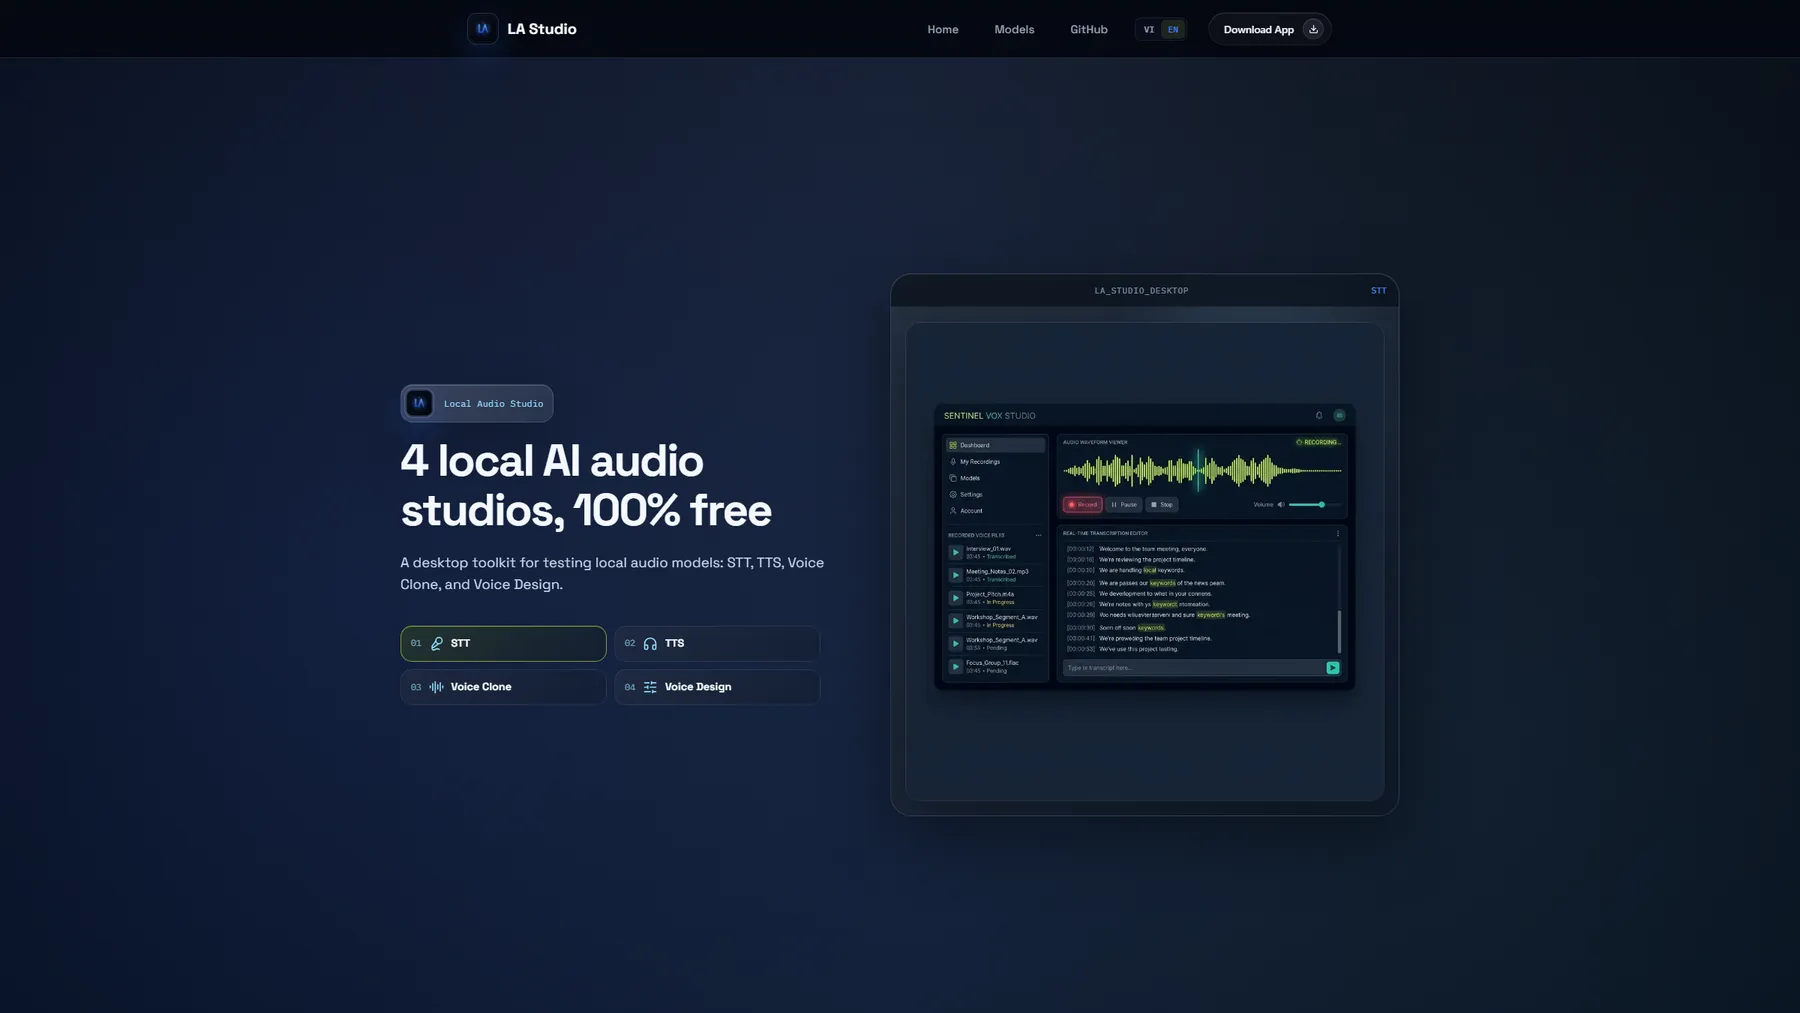
Bộ công cụ desktop để chạy mô hình audio AI ngay trên máy — chuyển giọng nói thành chữ, đọc văn bản thành giọng, nhân bản và thiết kế giọng.
- Vai trò
- Tự làm toàn bộ
- Nền tảng
- App desktop + web
- Giá
- Miễn phí, mã nguồn mở
- Ngôn ngữ
- Tiếng Việt / English
- Trạng thái
- Đang phát triển
Bối cảnh
Muốn thử một mô hình audio chạy cục bộ, người dùng phải tự dựng môi trường cho từng model: runtime khác nhau, định dạng khác nhau, tài liệu rải rác. Còn phần lớn công cụ sẵn có thì gửi âm thanh lên server — không dùng được khi file là bản ghi họp, phỏng vấn hay giọng của khách hàng.
Việc tôi đã làm
Tách rõ hai lớp: web là nơi tìm hiểu và chọn model, app desktop là nơi chạy workflow thật trên máy người dùng.
- Bốn studio riêng biệt trong một app — Speech-to-Text, Text-to-Speech, Voice Clone, Voice Design — mỗi loại thử nghiệm có không gian làm việc riêng thay vì một form đa dụng.
- Quản lý model và runtime theo metadata: tải asset, kiểm tra file, dò phần cứng và chọn CPU / CUDA / Vulkan cho đúng máy.
- Ghi âm, phát lại, xem waveform, lịch sử và xuất file trong C++17 với Qt 6/QML, kèm test tự động cho các luồng chính.
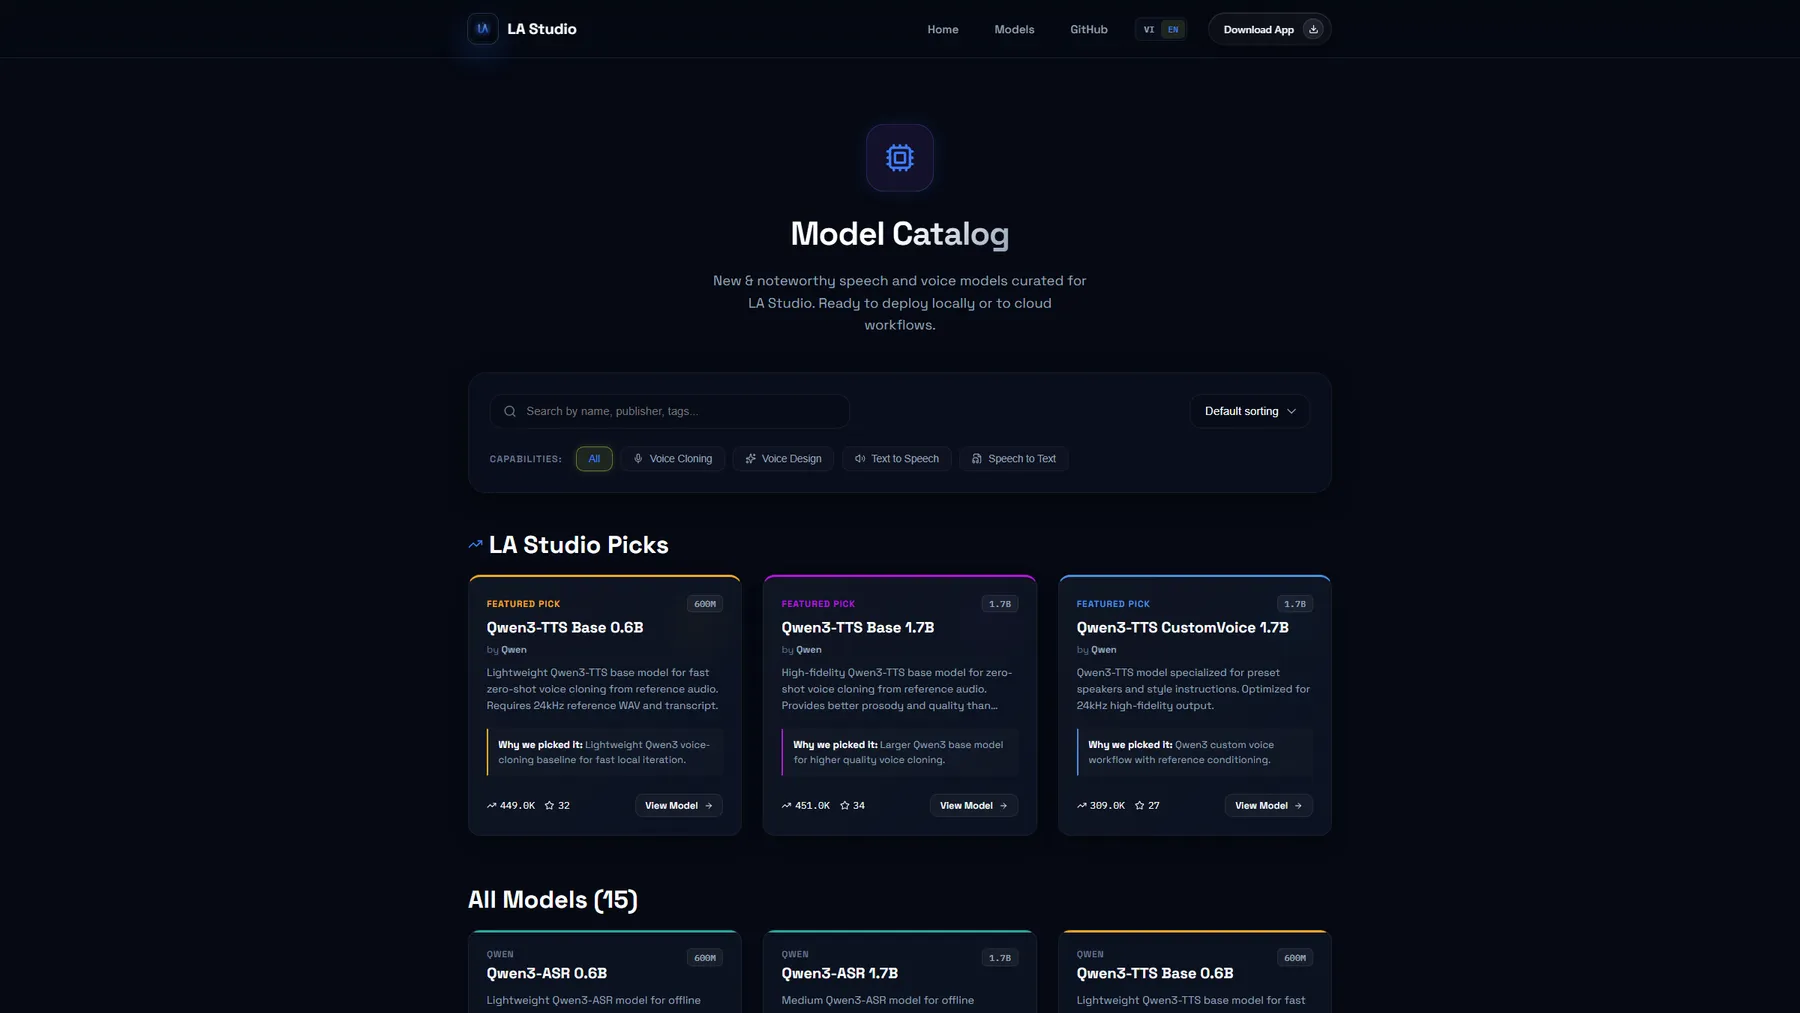
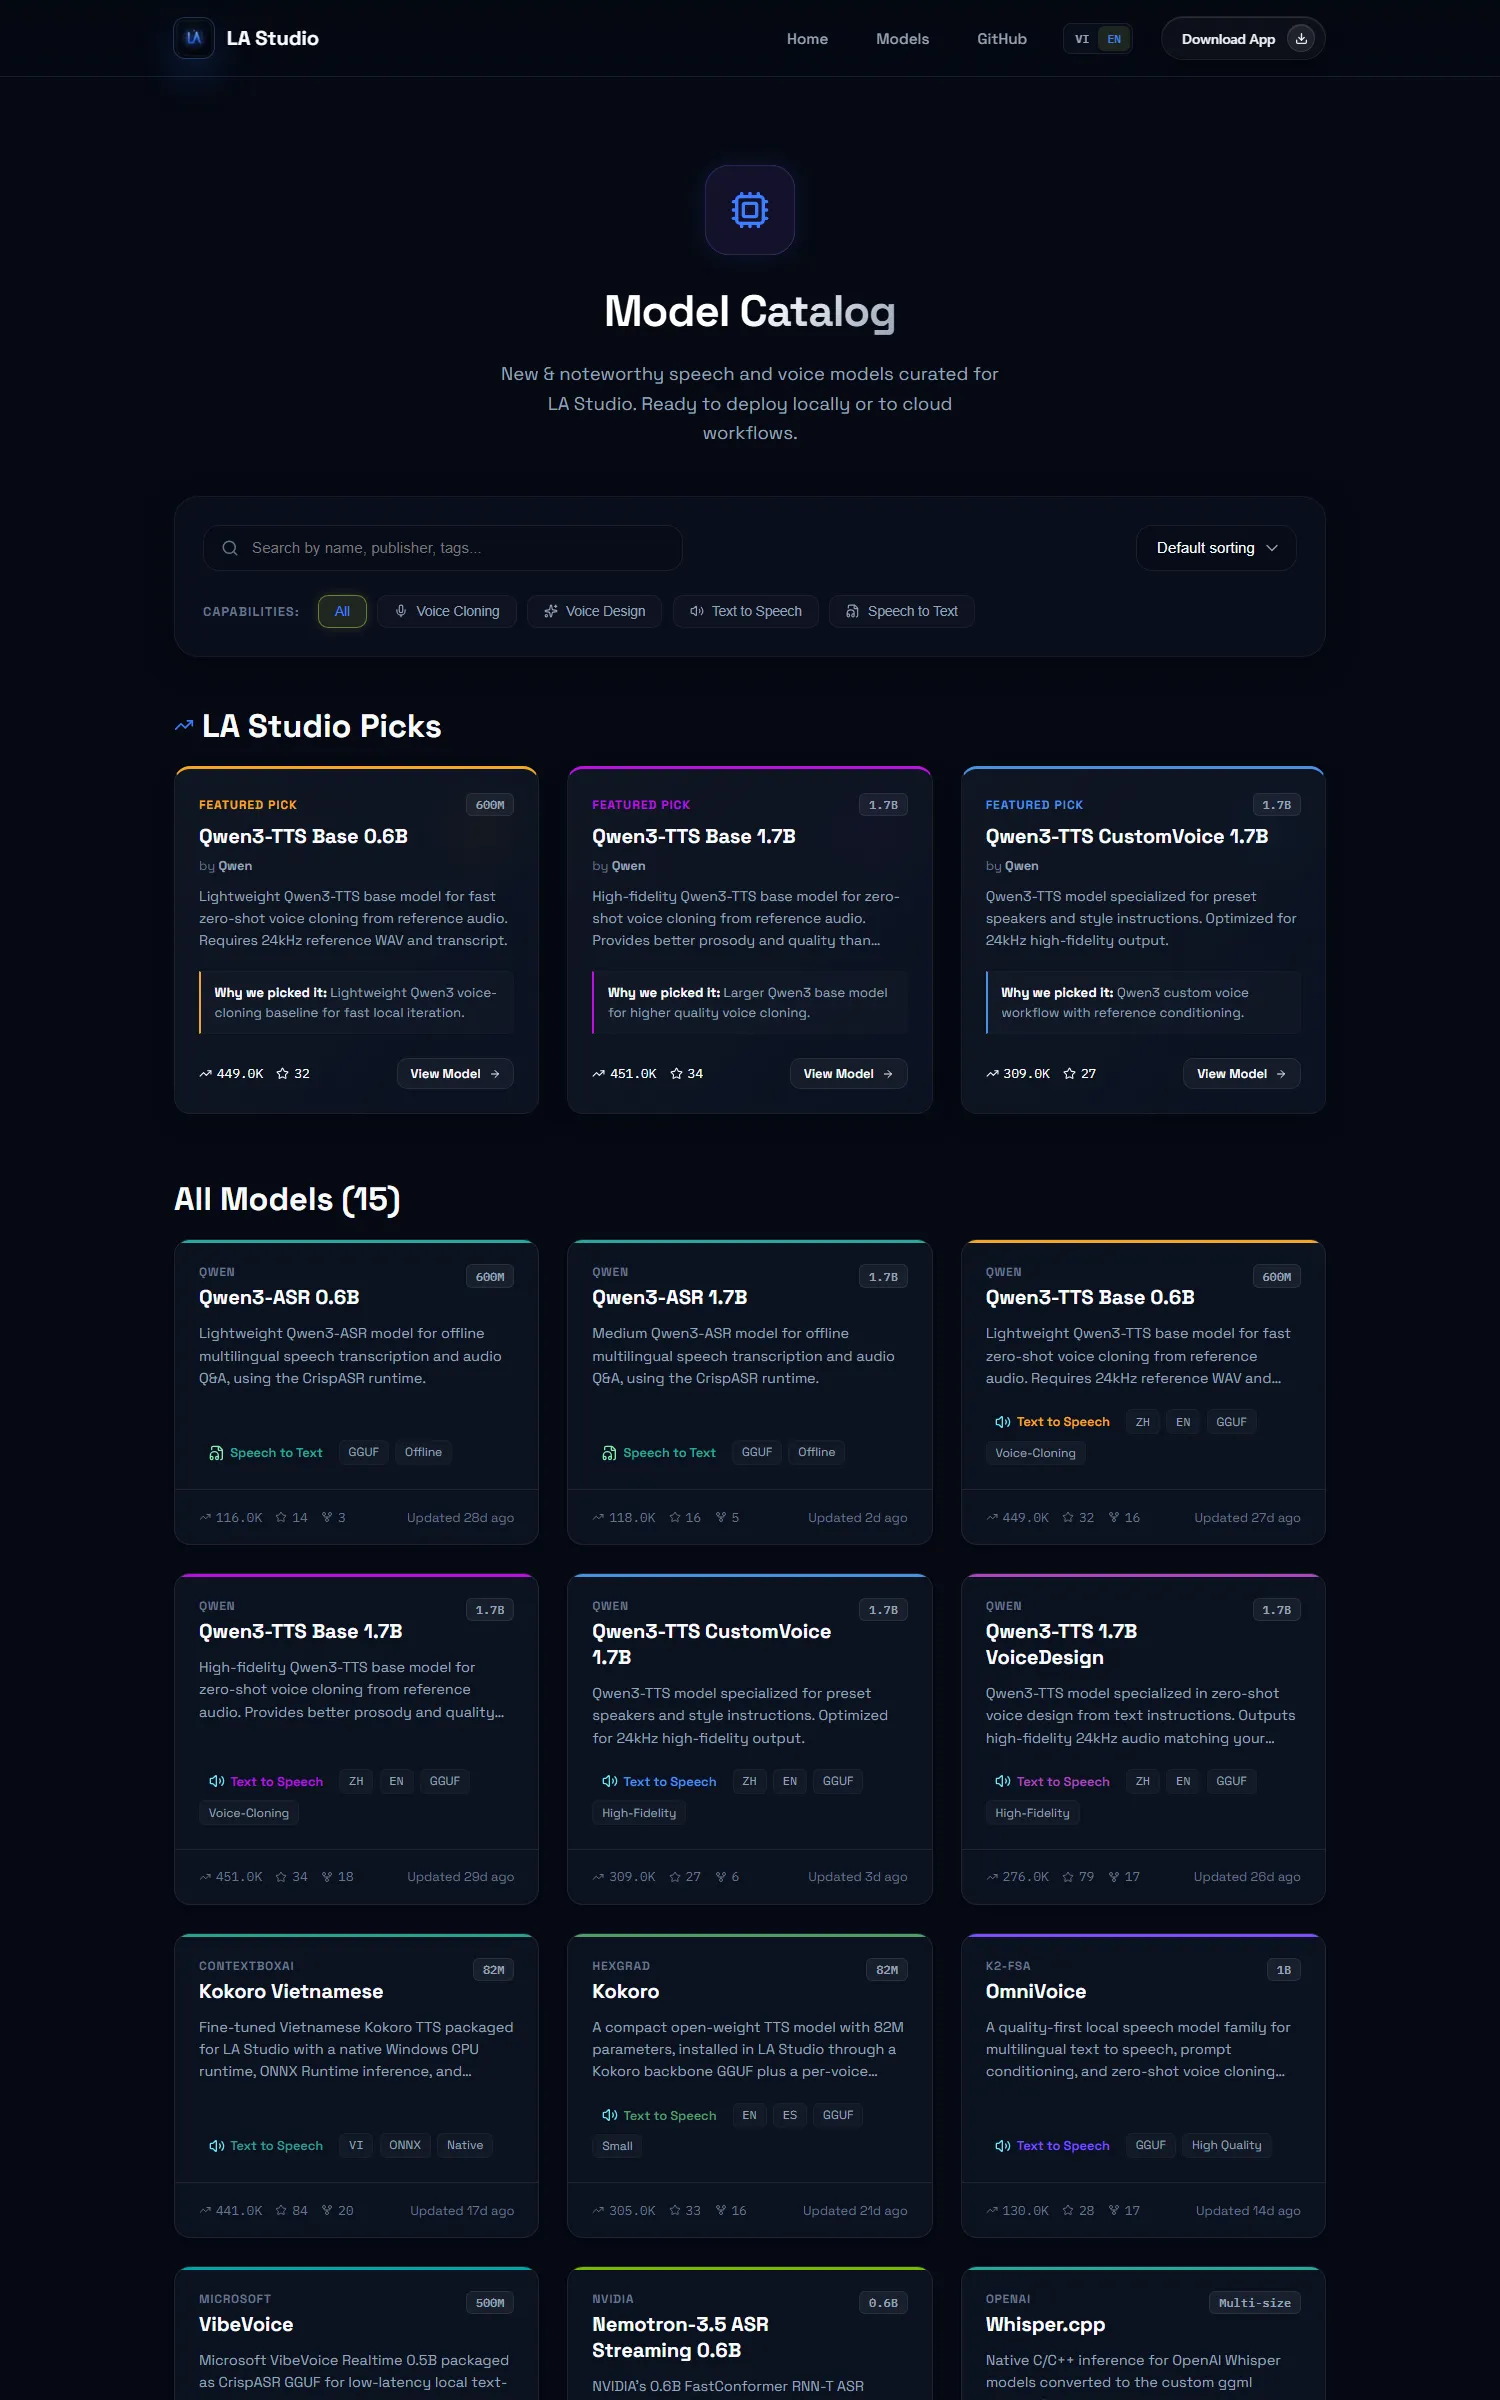
- Catalog model trên web: nhóm theo khả năng, kèm runtime, định dạng, kích thước và trạng thái offline, để biết máy có chạy nổi trước khi tải về.
- Local-first là mặc định chứ không phải tuỳ chọn: âm thanh không rời khỏi máy.
Kết quả
- 4
- studio trong một app
- 15
- model đã có trong catalog
- 100%
- miễn phí, chạy cục bộ
Hướng phát triển
Không dừng ở việc thử model, mà tiến tới các workflow audio hoàn chỉnh.
- Làm audiobook: chia chương, chọn giọng, tạo bản đọc dài và quản lý nhiều đoạn audio trong một pipeline.
- Lồng tiếng video: ghép transcript, bản dịch, chọn giọng và canh thời gian hội thoại, vẫn ưu tiên xử lý cục bộ.
- Workflow nhiều bước: nối STT, TTS, voice clone, voice design, runtime và catalog thành pipeline dùng lại được.
Màn hình